FAA 那句「全国停飞」通告出来的时间是 11 月 13 号。ATCSCC 通告 120 的原文很干,没一个字废话:
ATCSCC 120 DCC 11/13/2026  NATIONWIDE GROUND STOP
DESTINATION AIRPORT: ALL
REASON: COMMUNICATIONS FAILURE
EFFECTIVE TIME: 132246 - 140430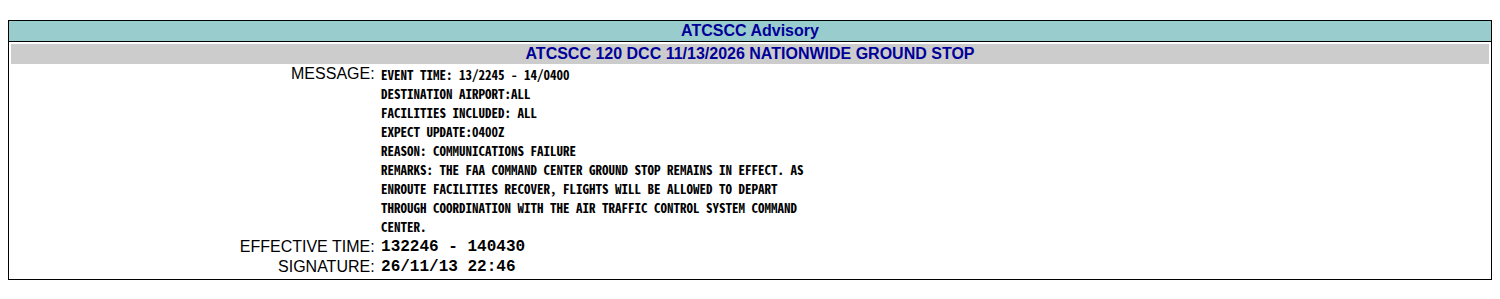
全国空域停飞,加上「通信失效」这四个字,官方问答里被问到最多的两个问题——是不是网络攻击、是不是那套新上的 SMART 系统干的。这两个猜测,方向都反了。
官方后来把机制讲清楚了
11 月 15 号 FAA 出了份官方问答,我用原话:
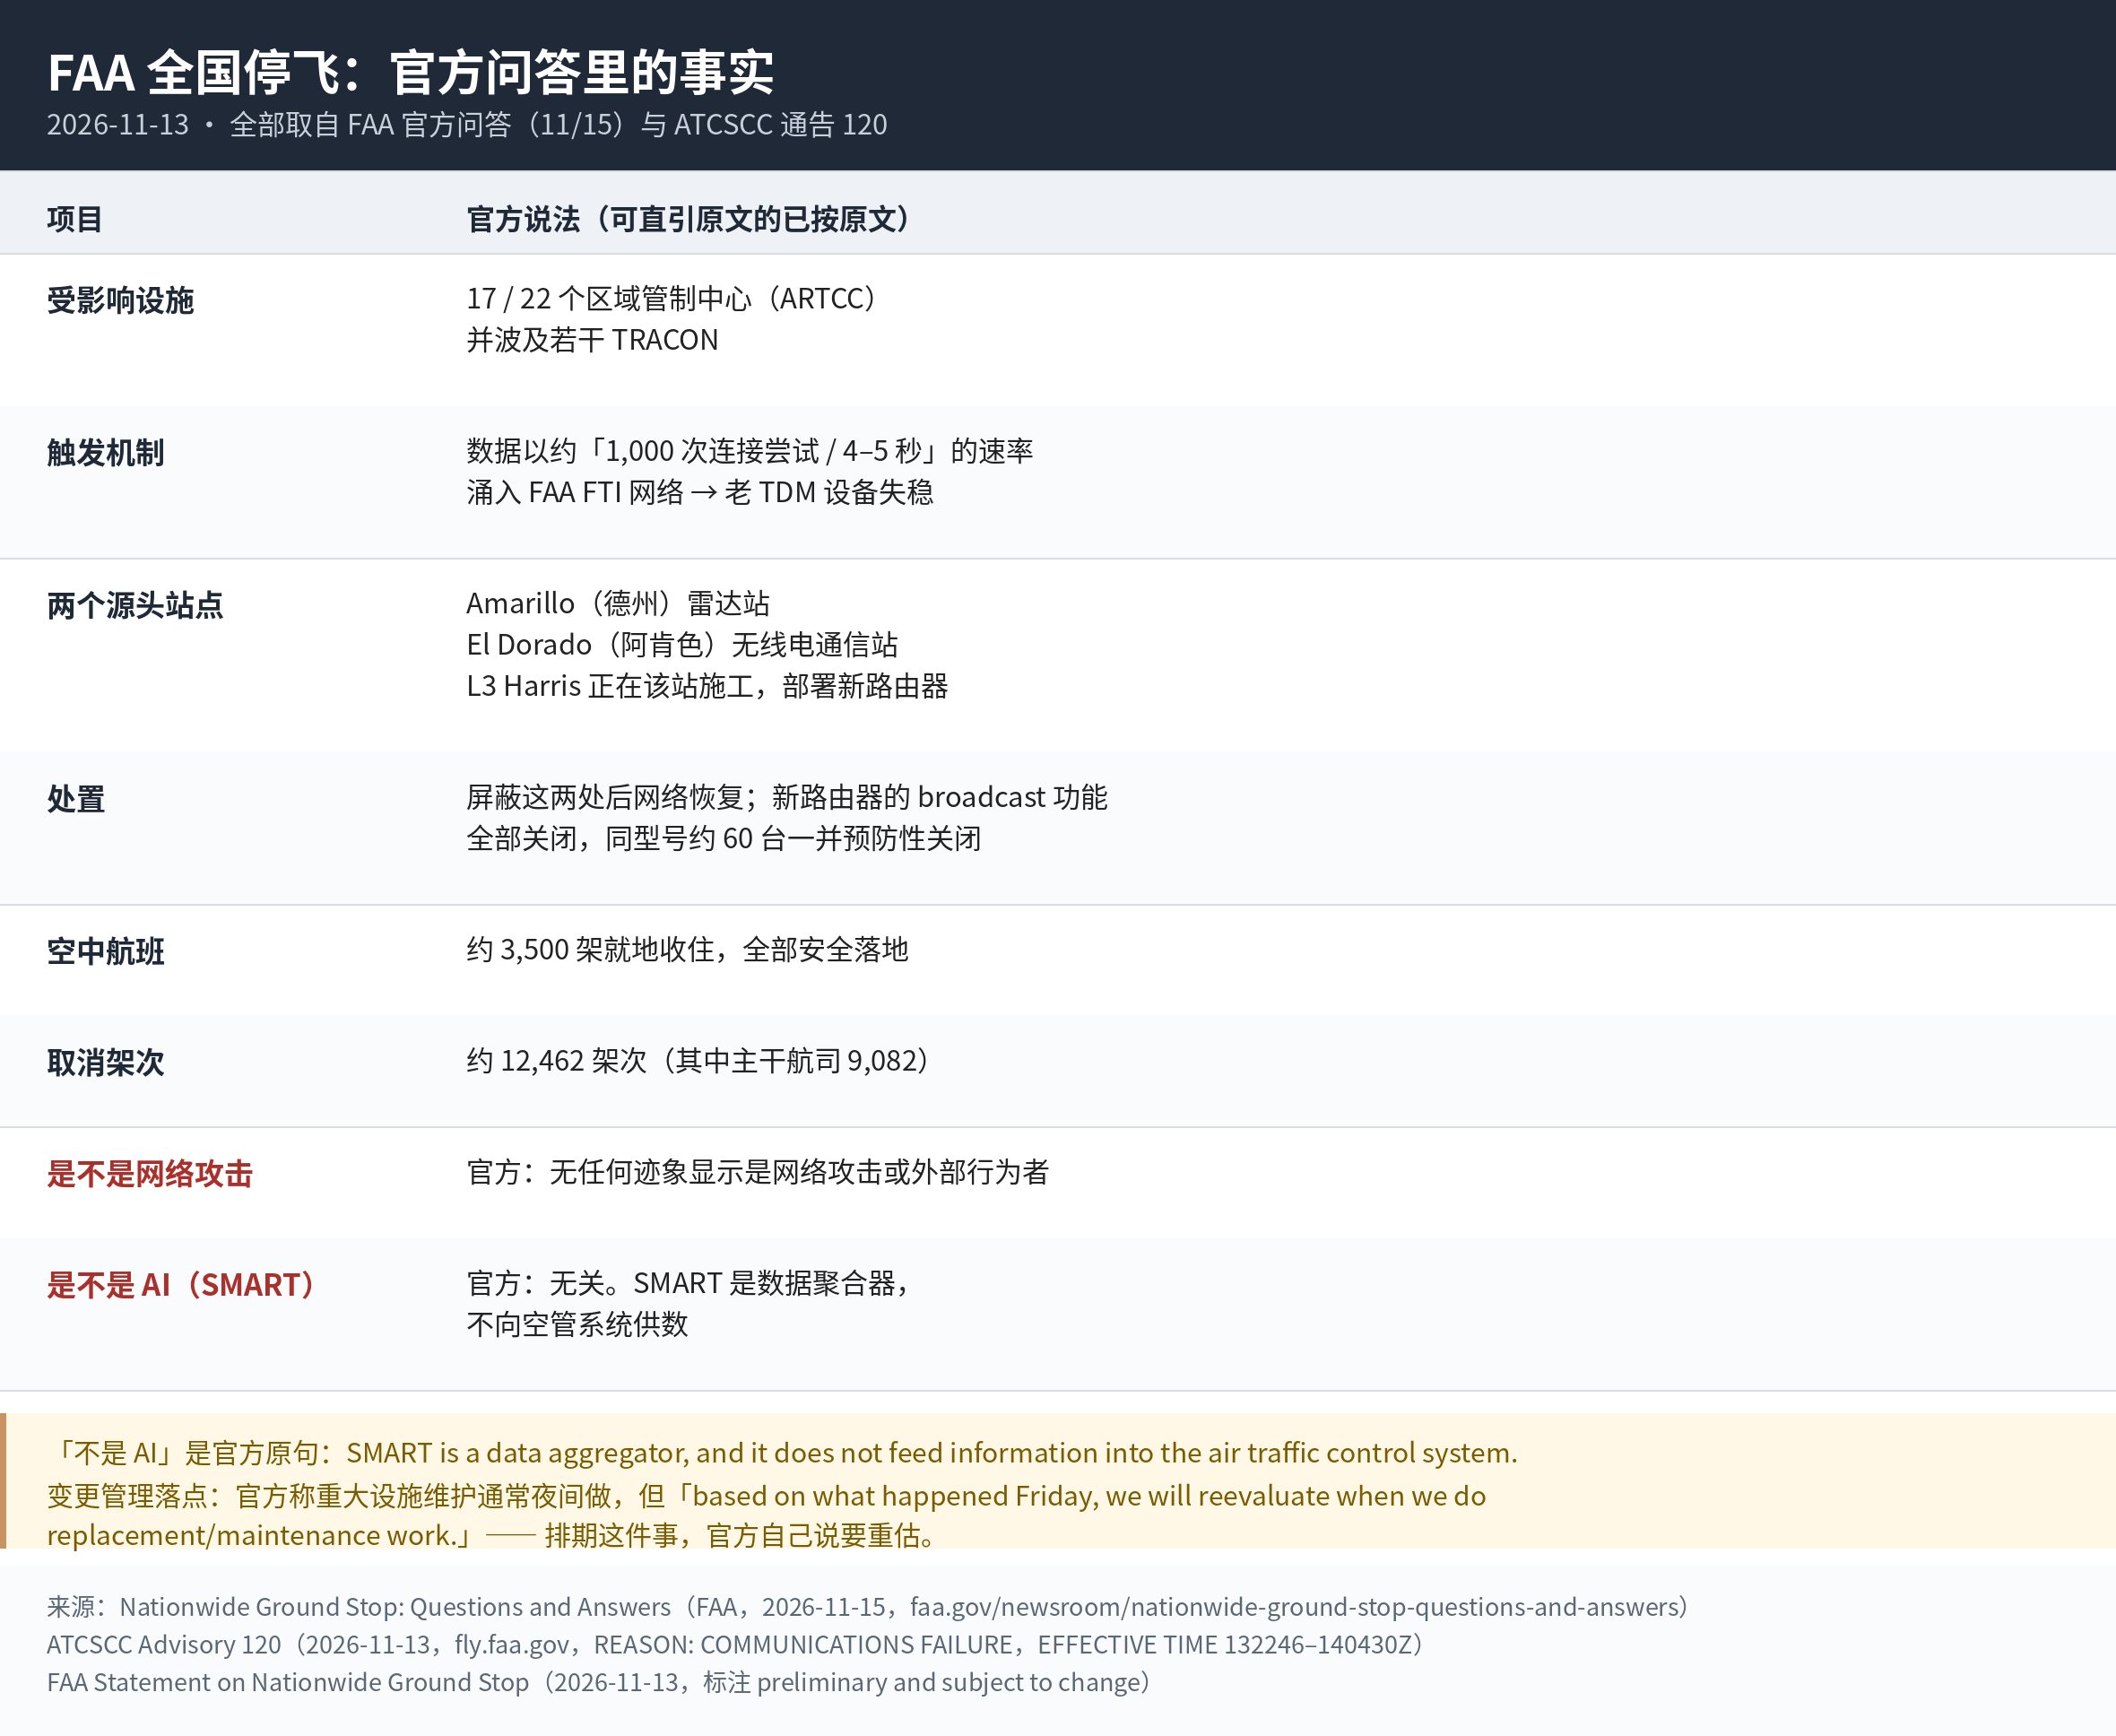
The FAA's legacy equipment became unstable when data began flooding the FAA FTI network, at a rate of 1,000 connection attempts every 4 to 5 seconds.
两个源头:德州 Amarillo 的一个雷达站、阿肯色州 El Dorado 的一个无线电通信站。而 FAA 现在的网络服务商 L3Harris,当时正在 El Dorado 做割接,部署了一台新路由器。
处置很干脆:把这两个站点屏蔽掉,网络就稳了。然后把那台新路由器的 broadcast 功能关掉做预防,再把系统里大约 60 台同型号路由器的同一个功能一起关了。
所以这次不是「流量大」,是新增路由器的一个广播/连接行为,把下游的老设备压垮了——每 4 到 5 秒一千次连接尝试,这个量级本身不算大,可它砸在的是一套靠 TDM(时分复用,铜缆那套)撑着的老系统上,官方说这属于 due to the legacy TDM system causing instabilities,背景是铜缆到期、往光纤(TDM→IP)过渡。
受影响的是 22 个航路交通管制中心里的 17 个,外加若干个终端雷达进近管制(TRACON)。不是「22 个全崩」,官方特意点了这一句,还说 this was not a full outage. Some frequencies and radar feeds remained reliable.
甩锅链和证据链之间,差着一份变更记录
否定也很清楚:
Based on all available evidence, we have no indication that this was a cyberattack or an outside nefarious actor.
有人问是不是 SMART 系统(一种数据聚合器),问答里直接否了:
No. The two systems are not related. SMART is a data aggregator, and it does not feed information into the air traffic control system.
航空侧的数字,用官方的:约 3,500 架飞机在空中就地收住、安全落地;11/13 当天取消 12,462 个航班,其中主干航司 9,082 个。这里注意时区——通告用的是 Z 时间,问答用的是 ET,别自己换算成「停了 X 小时」,网上流传的「四个多小时」是二手口径,我没用。
回头看这件事,最值得记的不是那台路由器,是故障窗口和变更窗口重叠这件事本身。出事的那一刻,所有人第一反应都是「最近改了什么」——这次恰好赶上 L3Harris 在割接,就被顺理成章地怀疑上了。虽然最后官方把 AI 和网络攻击都否掉了,但你想想:要是证据没这么干净、要是割接记录不完整、要是灰度跟回滚是拍脑袋定的,这口锅会不会就扣上了?
官方自己在问答里也认了这一点:
Maintenance at major air traffic control facilities is typically conducted at night, when there's less traffic. ... based on what happened Friday, we will reevaluate when we do replacement/maintenance work.
维护排期要重新评估——这句不是给 FAA 自己看的,是给所有做变更的人看的。老系统该退休、铜缆换光纤这事也做了几十年;但迁移过程本身就是风险窗口,这跟「升级一下就好了」是两回事。
之前写 微软 365 挂了十小时那篇 的时候是同一种感觉:一家公司最稳不住的时刻,往往不是被攻击,而是自己人刚动过手。再往早里翻,一个 DNS 缺陷瘫了半个互联网 15 小时 讲的是同一个道理的另一面——你觉得自己用的东西「从来没坏过」,不代表它没有窗口。
评论