先说结论,那天下午的负载 15,跟 CPU 一点关系都没有。是一台存储机的 NFS 断了两个多小时,业务机上凡是碰 /data 的进程全卡在 D 状态,一个都杀不掉,load 就这么被顶上去了。这个结论是事后才拼出来的,当时完全不知道。
三点十几分,值班的同事在群里甩过来一句:web03 连不上,ssh 上去敲 ls 没反应。我那时候正在给客户写部署文档,回了句「稍等」,顺手开了七亿批量远程管理工具——我平时管这批机器就靠它,几台机的 SSH 终端开在一个窗口里,谁出事点谁。切到 web03,先看负载:
$ uptime
 15:14:03 up 218 days,  3:41,  2 users,  load average: 15.12, 6.83, 2.94
15 点几,还在往上走。15 分钟那个 6.83 说明是十几分钟前开始爬的。
第一反应是 IO 打满。切去 top,CPU 那几行几乎是空的,us 不到 3,wa 倒是两位数。开到 iostat,几个设备的 %util 都很高,可 await 又不像在真写盘——读也读、写也写,数字就是不动。我盯着那块屏看了半分钟,觉得不对劲。
真正让我懵的是下一件事:ps 能出来,一 pipe 就死。
$ ps aux | head
(正常输出)

$ ps aux | wc -l
(光标闪,不返回,Ctrl+C 也退不出来)
df -h 一样,敲下去就挂着。再开个窗口 ls /data,也挂在半路。三个命令卡在三个不同地方,但最后都要去看 /data。
到这一步我才想起去瞄 ps 的 stat 列:
$ ps -eo pid,stat,wchan:24,cmd | awk '$2 ~ /^D/'
 3021 D  rpc_wait_bit_killable  php-fpm: pool www
 3044 D  rpc_wait_bit_killable  php-fpm: pool www
 3051 D  rpc_wait_bit_killable  php-fpm: pool www
 3076 D  rpc_wait_bit_killable  nginx: worker process
一排 D,wchan 全是 rpc_wait_bit_killable。D 是不可中断睡眠,kill -9 对这种进程没用,它得等它等的那个东西回来。
rpc 两个字提醒我了,去看挂载表:
$ cat /proc/mounts | grep data
10.0.0.5:/data /data nfs4 rw,relatime,vers=4.1,rsize=1048576,wsize=1048576,hard,proto=tcp,timeo=600,retrans=2 0 0
hard。再看 dmesg:
nfs: server 10.0.0.5 not responding, still trying
nfs: server 10.0.0.5 not responding, still trying
一屏一屏刷,全是这一句。
到这儿就通了:/data 挂的是 NFS,存储机 10.0.0.5 挂了,而挂载用的默认 hard 语义——不超时、不报错,一直重试。凡是走到 /data 上的系统调用,全被按在 D 状态出不来。负载计算是把 D 状态算进去的,所以 CPU 闲着,load 15。前面 ps、df、ls 卡的地方也是同一个原因,它们最后都要 stat 一下那个挂载点。df 会卡这事我以前只懂一半,那天算补齐了,不是 df 有问题,是它在等 NFS。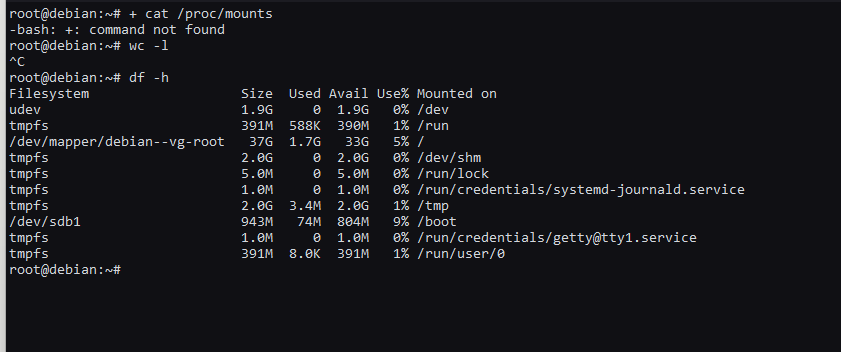
弯路得说一句。前面那二十来分钟我全花在怀疑 web03 自己的盘上,iostat、smartctl 都过了一遍,/dev/sda 各项正常,SMART passed。中间还想开 iotop,结果它一启动也卡住了(后来才想明白,iotop 要读的东西里也有它)。真正把我拽回正道的是 rpc_wait_bit_killable 那行 wchan,以前我从没这么细看过它。
处理没什么技术含量。存储那台是隔壁组管的,我给管存储的同事打了个电话,人家也是刚发现,正查着——网卡先协商掉到 100M,后面整个 down 了,我这头只是被殃及的。人家刚发现问题我就追过去问,语气上多少得客气点,毕竟这锅本来也不是他们的。存储拉起来之后,web03 上那排 D 进程自己就活了,ls /data 正常返回。中间我一直没敢 umount -f,强卸之后 NFS 上还挂着的句柄容易再出别的事,宁可等。
事后改了两处。一是把这几台机器的 NFS 挂载加了 soft,timeo=30,retrans=3,宁可 IO 直接报错让应用层去重试,也不让一个挂载点把整台机器拖死;顺手在 /etc/fstab 对应行补了 _netdev,省得开机顺序不对起不来。二是上了 autofs,改成按需挂载,不用的时候不挂着。这个也有争议,有人说会多一跳延迟,看场景。
那天之前,我一直觉得 hard mount 是「更安全」的选择——数据一致性嘛。现在我知道安全是安全,代价是整台机器能被一个远端服务按死。这种拿数据安全和可用性做交换的取舍,好像也没有绝对的对错,就看你能接受哪种后果。
写这篇的时候我又上了下 web03,load average 0.42。跟那天那 15 点几比,像两台不同的机器。
上次那个删文件把窗口卡死的坑,根子其实也是「在等一个回不来的东西」,回头单独写。
(这几台机器我还是老样子,开着七亿批量远程管理工具一台台连过去,SSH 终端能同时开好几个会话,真出事了切起来快一点。)
(ps:这套远程工具我日常用的是 v1.6.1,免费版下载:七亿批量远程管理工具 v1.6.1,Windows 上跑,RDP 九宫格 / SSH / SFTP / FTP 都在一个窗口里。)
评论