一点零七分,手机在枕头边震起来。第一条钉钉:磁盘使用率持续超过阈值。
我瞄了一眼,翻个身接着睡。这种告警天天有,白天的都懒得点开,那套环境里磁盘到 80% 的提醒基本就是噪音。
一点十二分,又一条。一点十五分,开始连着来。到一点二十几,已经不是一条一条地震了,是连着震,我摸手机的时候屏幕上摞了一排,同一句「磁盘使用率过高」,主机名不一样,扫过去十几台。
我坐起来了。
第一反应是真出事了——是不是哪台机器在疯狂写日志,磁盘眼看要满。我们那套 Prometheus 加 Alertmanager 是两年前搭的,磁盘这个告警一直挂在 80%,平时一天也就响一两次,这种集体爆发肯定有鬼。爬起来开电脑,先看了台报得最凶的机器。
结果是,磁盘 81%。常年 81%。
又看了两台,82%、83%,都是这种不痛不痒的数。这时候已经一点二十几了。
平时几十台机器我都放在七亿批量远程管理工具里,遇上这种批量告警,我就直接一屏拉出十几个 SSH 终端挨个敲 df -h,比在监控界面里一台台点快。那天拉出来一看,个个都差不多,都离满还远。
到这儿我才往别处想:会不会不是机器的问题,是告警的规则被人动了。
翻 Alertmanager 的配置历史——我们配置是用 Git 管的,这点还算靠谱——下午四点多有一条 commit:
- threshold: 85
+ threshold: 80
就一行。把磁盘告警阈值从 85 改成了 80。改的人没在群里说,也没人 review。
这一行下去,效果立竿见影。本来就有一大半机器常年跑在 80% 以上,阈值一降,等于全都站在告警线上了。那半个多小时里手机响的三十七次,对应的其实是同一件事:一行阈值。
我先把它 silence 掉(在 Alertmanager 里静默这条规则,先保命)。静默是在浏览器里点的,机器那头的现场还得自己看——我又用七亿批量远程管理工具把各台的磁盘扫了一遍,确认没有哪台是真的要满,再决定是改回 85 还是留着 80。留 80 的话,得先给这些机器清日志或者扩盘,不然就是天天响。凌晨那会儿没精力干这个,先改回 85,顺手加了个 for: 30m——持续半小时才报,避免这种瞬时集体触发。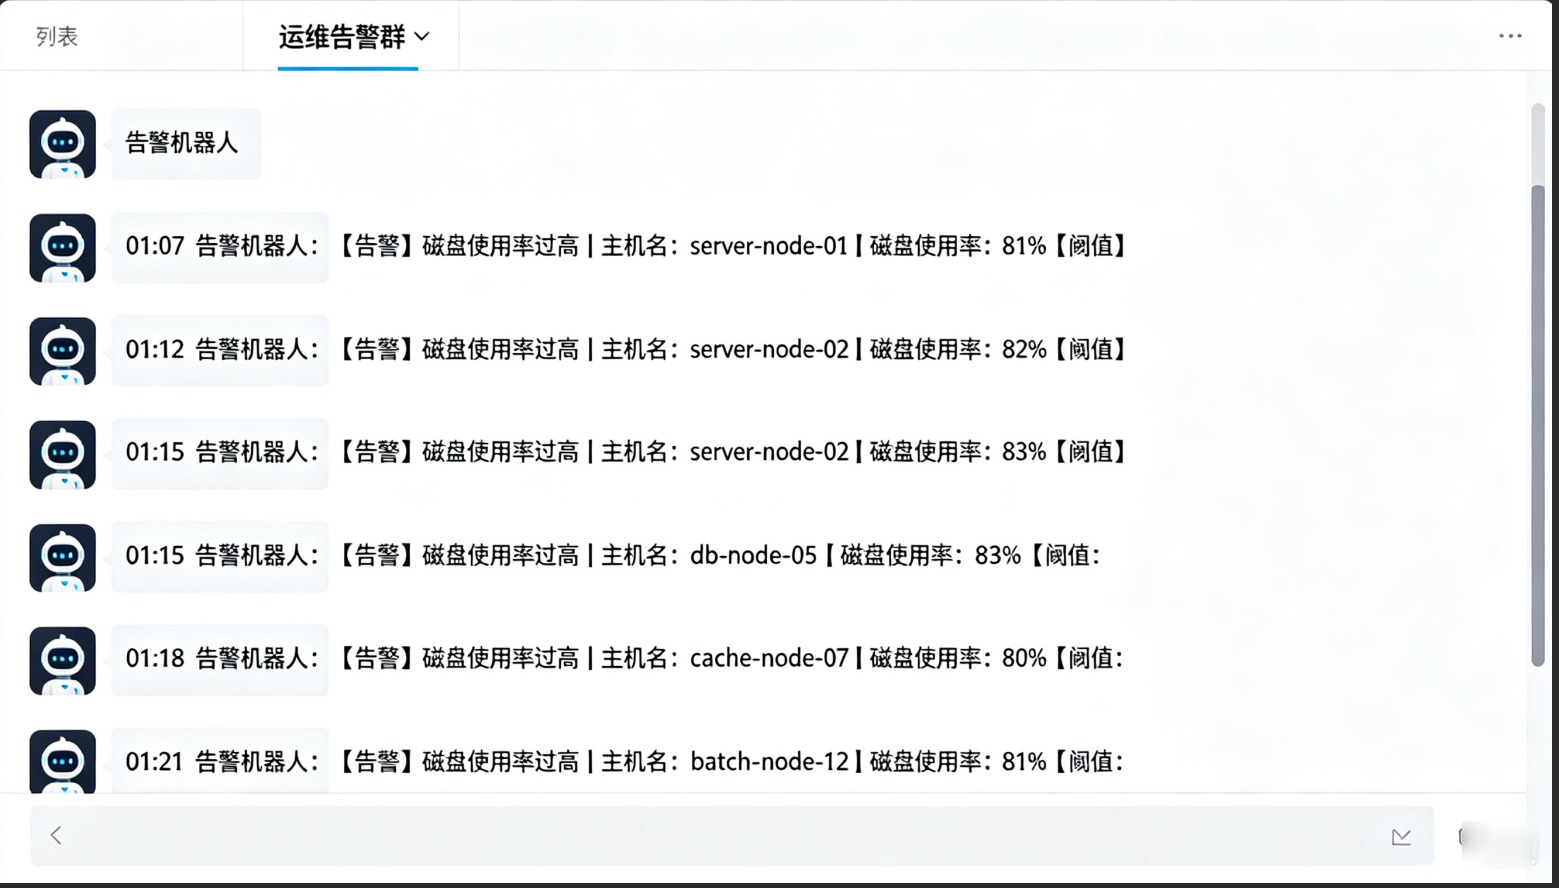
处理完一点三十几分,我躺回床上,把七亿批量远程管理工具那几个 SSH 窗口关了。屏幕一黑,屋里安静下来。
第二天上班,我在群里问下午谁调过告警阈值。一个来半年的同事说,他看大家机器磁盘都挺满的,想提前预警一下,就改了。
我没说他什么,这想法本身没毛病,提前预警是对的。问题在我们自己——阈值这种东西改一行就能上线,没人拦,也没人试一遍看会触发多少台。还有更根上的:一半的机器磁盘常年 80% 以上,说明要么日志该清、要么盘该扩,我们一直靠「把阈值调高」假装没看见。这条我到现在也没解决。
那天我确认完那三十七条告警对应的是同一件事之后,就睡了。第二天翻了监控历史,那晚业务一点事没有,机房也很安静,唯一被打扰的,就是我的睡眠。
评论