df -h 说根分区 99%。我接着敲 du -x -d1 -m / | sort -rn,想看看是哪个目录在疯长——排最前面那几个加起来,才 4 个 G。
用了 57 个 G,数出来只有 4 个。中间那 50 多个 G,像是凭空蒸发了。
那是例行的巡检先报的警。一台宝塔机,CentOS 7,盘上跑着 nginx、PHP 和面板。真要因为空间把服务拖崩,写日志、写临时文件一报 no space 就得全线趴窝,所以这事当天就得处理。现在回头看,整件事的转折点不在磁盘,而在我先入为主、找错了地方。
网站文件在数据盘上,日志才 1.5 个 G,系统目录更是干净。按老经验,先把几个「假满」的可能排掉:lsof +L1 看有没有「删了却还被进程攥着」的大文件——没有;find / -xdev -type f -size +100M 找大文件——也没有。df 和 du 这对数平时对不上,大都有现成解释,这一回一条都套不上。
露头是在 du 卡住的那一刻。它扫到 /var/spool/postfix/maildrop 这一层就不动了,光标搁那儿转了好几分钟。我一开始以为磁盘要挂,后来才反应过来——它不是在算大小,是在读一个上千万项的目录。那种卡,是正常的。
进去数一下:
ls -f /var/spool/postfix/maildrop | wc -l
# 12243612
一千两百多万个文件,全躺在 postfix 的邮件队列里。tail /var/log/maillog 刷得看不清,核心就一行 postdrop[...]: warning: unable to look up public/pickup: No such file or directory。随手抽一封出来看:
From: (Cron Daemon) <root>
Subject: Cron <root@www> check-rstack-control
command not found
原因到这儿就清楚了。这台机装了 postfix 的包,服务却是停着的、从来没起过——所以邮件只进不出,全淤在 maildrop 里。可这些邮件是哪来的?cron。
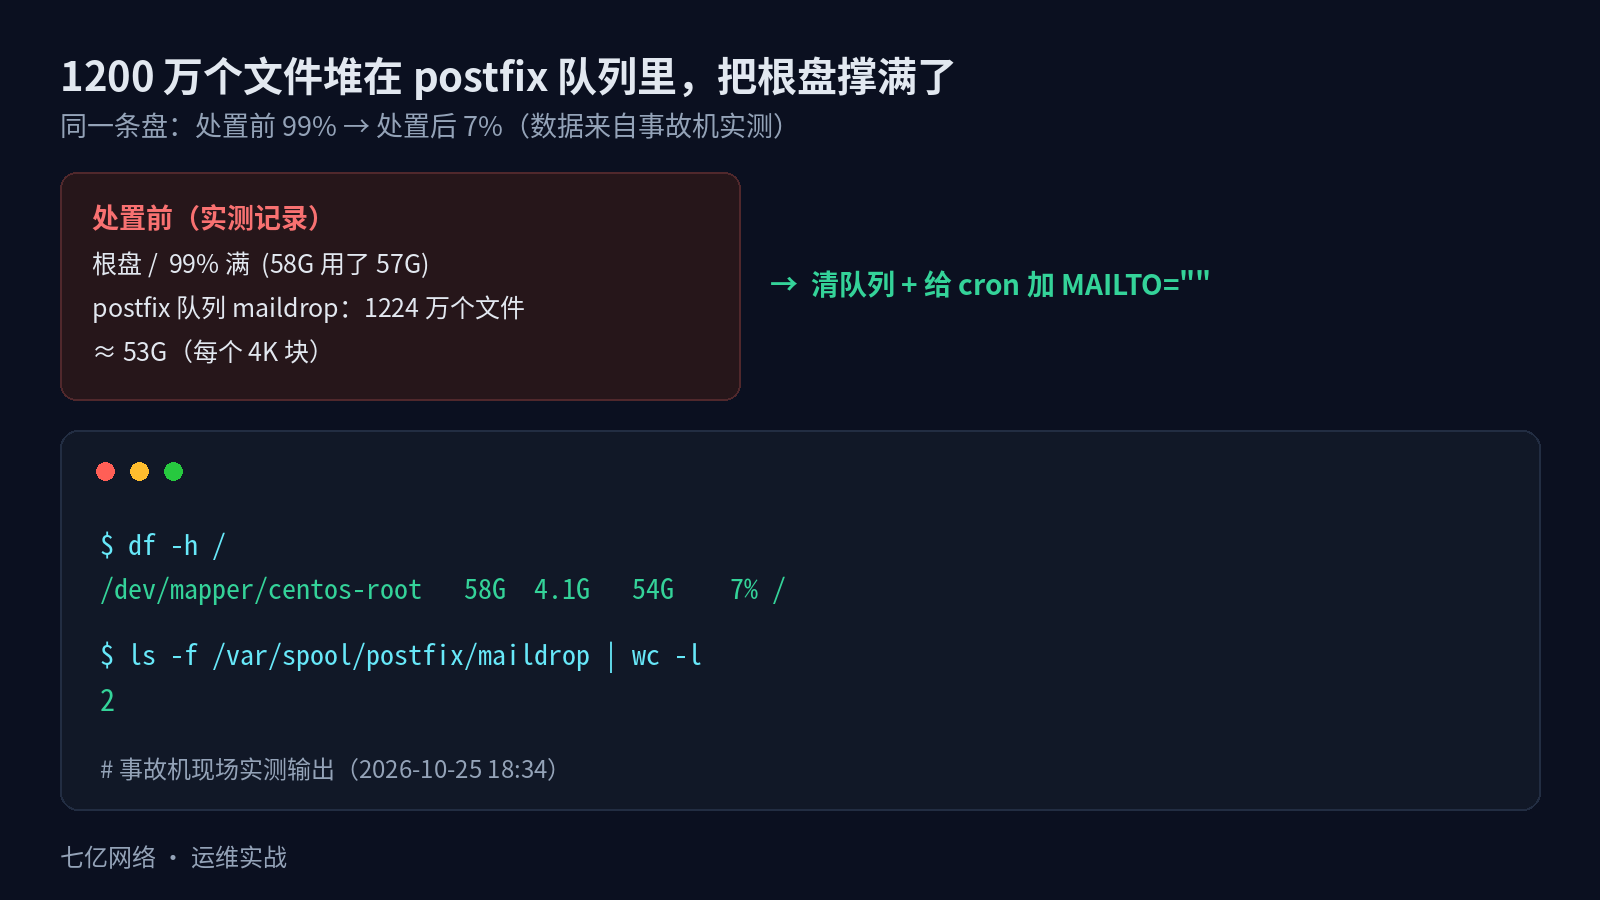
cron 有个默认行为,很多人不知道:定时任务只要有输出,它就给属主发一封邮件。这台机的 crontab 里挂着两条根本跑不起来的命令,每分钟跑一次、每分钟吐一句 command not found。一分钟十几封报错邮件,日积月累,就堆成了这一千两百万个文件、五十多个 G。既不是被黑,也不是日志写爆——是一个被忽视的默认行为,撞上了两个没配好的东西。
修起来不长。先把 root 的 crontab 备份一份,然后在顶部加一行:
MAILTO=""这一步是从源头止血,cron 从此不再发邮件。然后清队列:
find /var/spool/postfix/maildrop -mindepth 1 -delete一千多万个文件,后台删了十几分钟。删完复核:df -h 从 99% 掉到 7%,maildrop 归零,maillog 也不长了。
这类「空间去哪了」的问题,我之前写过一次,MySQL 的 binlog 一天涨了 7 个 G,同一种味道——盘满只是表症,底下总压着一个被默认掉的细节。再往前还有更早的一桩,磁盘挂载掉了、数据别删,那回是 fstab 写错了盘名。几件事放在一起看会发现,坑往往不在多高深的地方,就藏在一个「默认如此、没人细想」的行为里。真要排查的时候,先别急着删文件——七亿运维科普里把「du 对不上 df」的几种经典情况列过,顺着挨个排,比瞎删快得多。
留一句给自己:这回最险的不是那 1200 万个文件,是我差一点在开头就去删一个其实根本没问题的目录。先数清楚,再动手。
评论