「磁盘又满了,binlog 你清一下。」
那天收到这句的时候,我还没意识到,最后真正要处理的不是 binlog 本身,而是「怎么删」这件事。
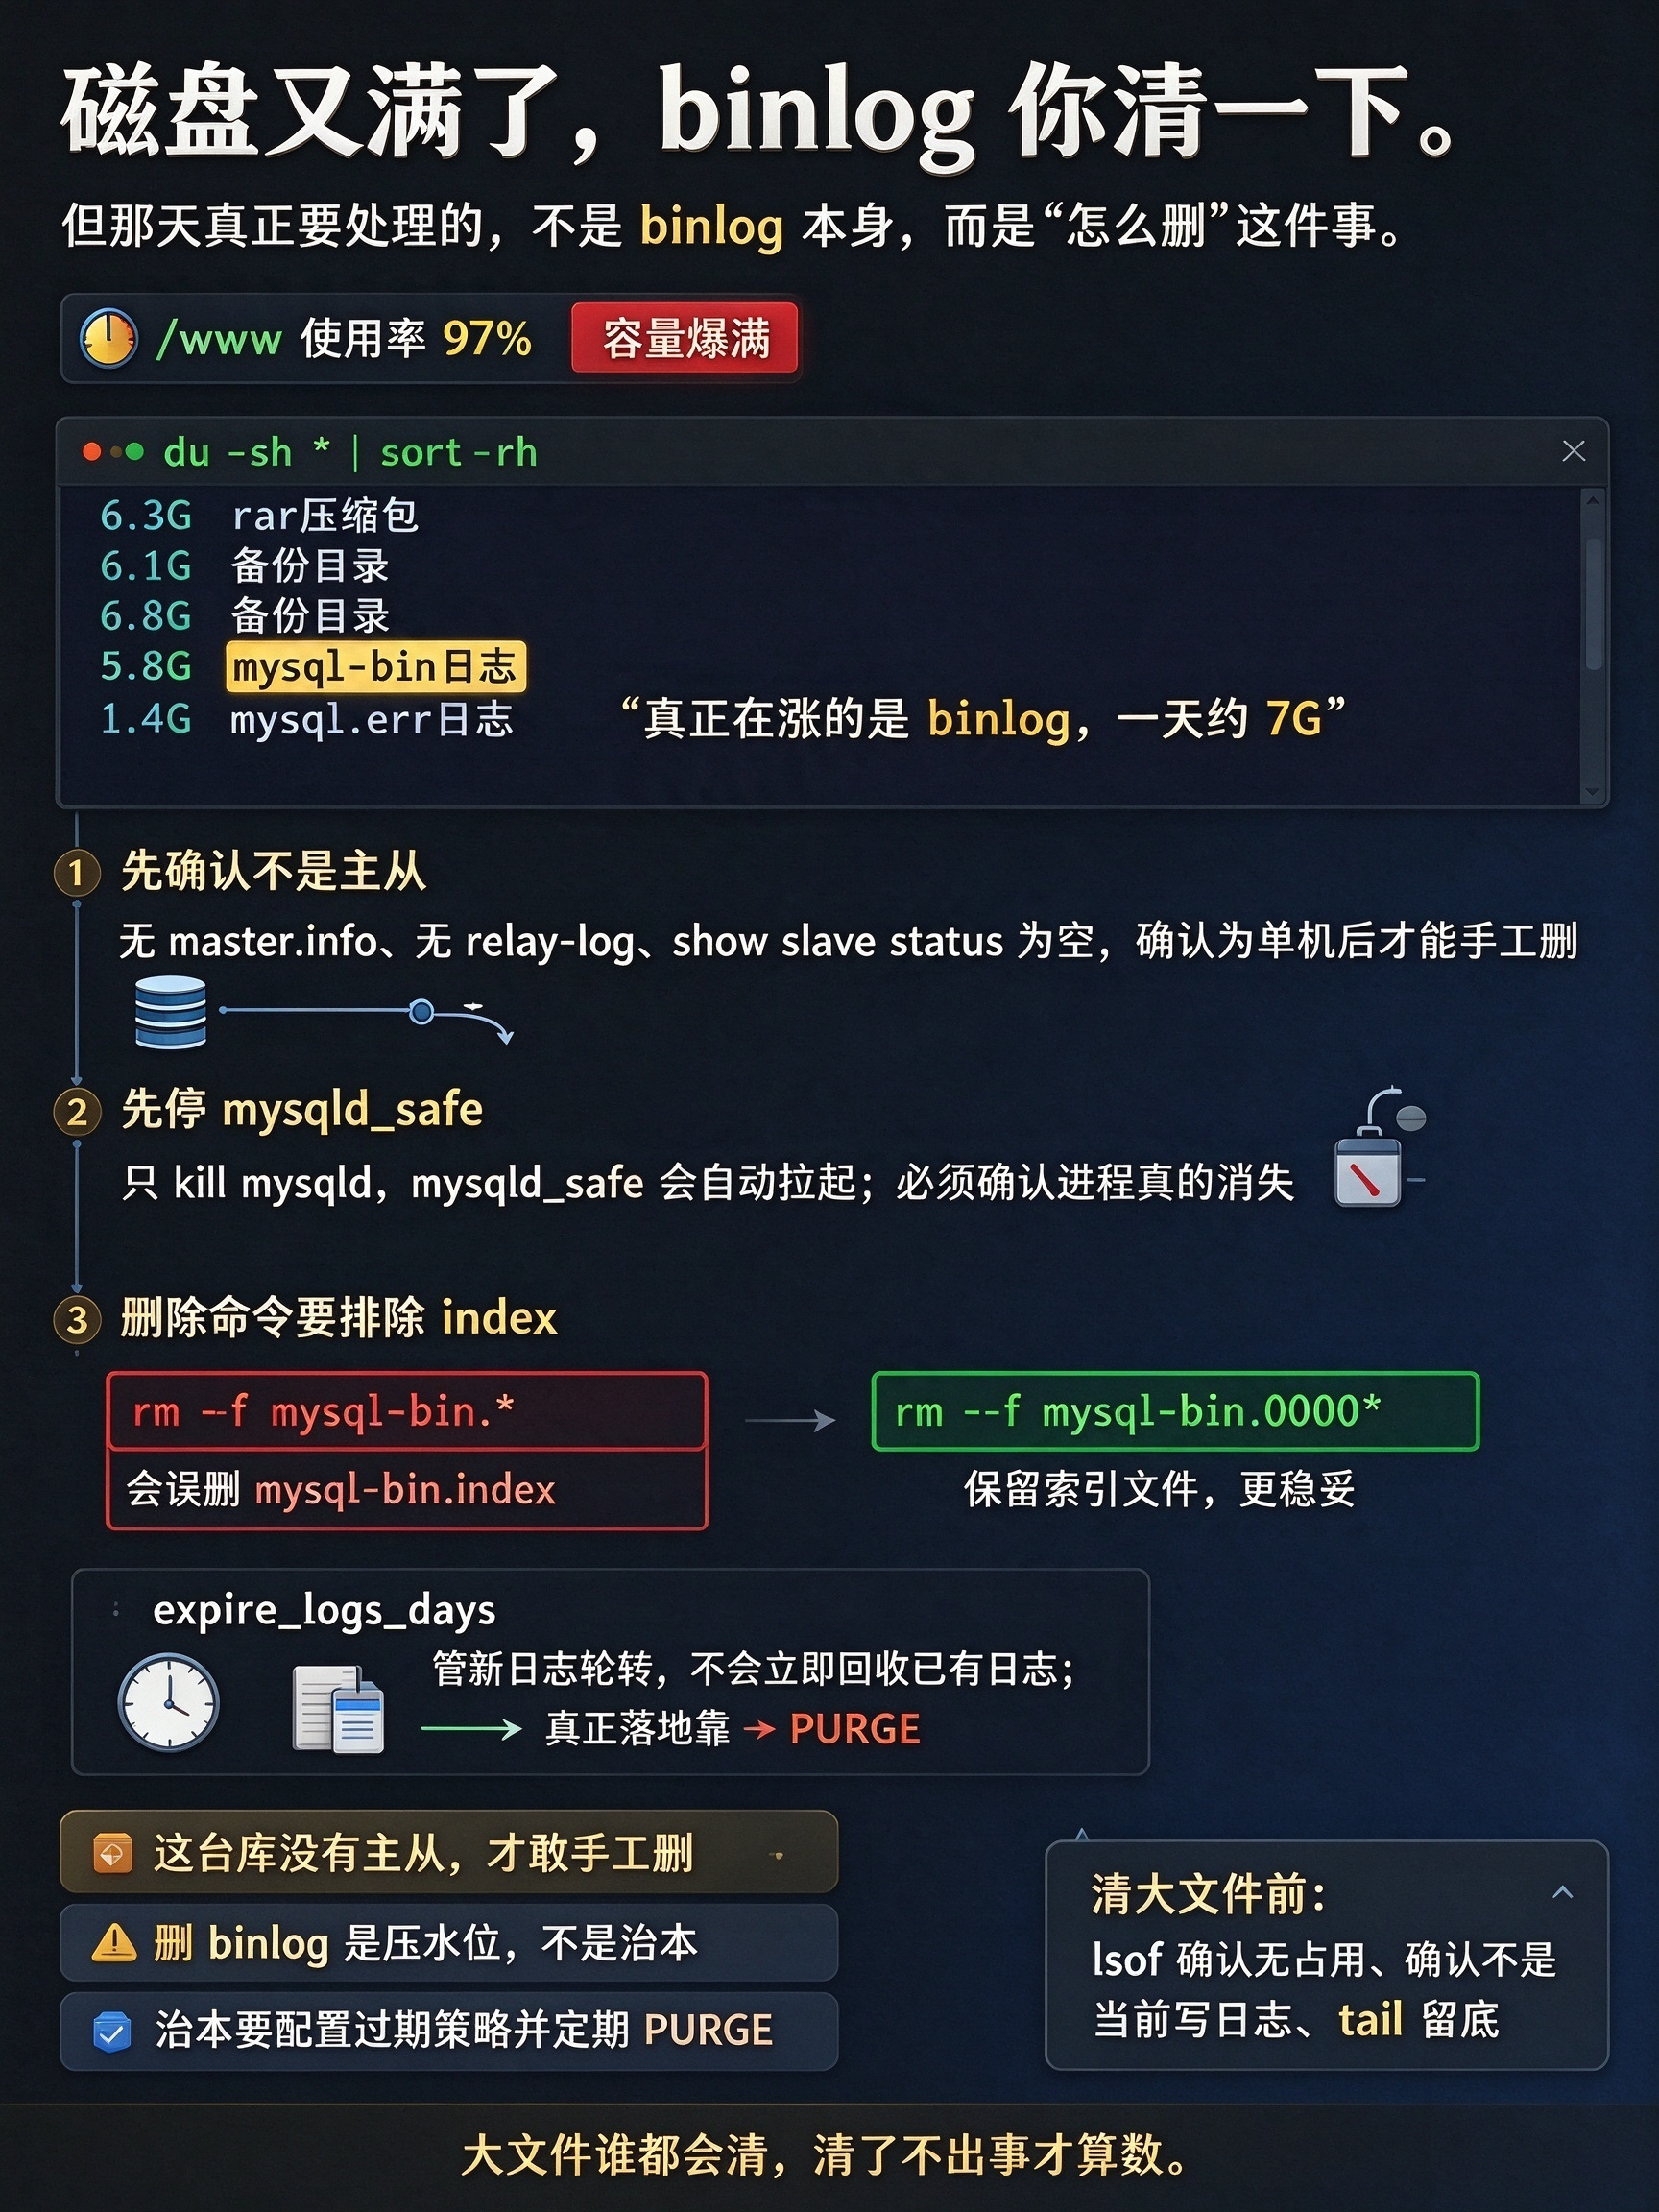
机器 97%。先找大件:binlog 5.8G、一个备份目录 6.1G、几卷 rar 6.3G,还有个 1.4G 的 err 文件。真正在涨的是 binlog——前一轮清完没几天,一天过去又涨了差不多 7 个 G,等于每天往盘里多塞 7 个 G。按常理它有过期时间,到点会自己清,可这台机器上那句配置等于没配。
查下来才明白:expire_logs_days 管的是新日志的轮转节奏,已经堆在那儿的、正在写的那个文件,它不会回头替你回收。到点了它只是把旧的标记成可删,真正落地还得靠 PURGE。
正常做法就是 PURGE。但那天 root 口令已经失效——面板库里存的密码只有 5 位,连进去就是 Access denied。PURGE 这条道走不通,只剩手工删。
手工删 binlog 有个前提:先确认这台库没有主从。 删掉还在被从库拉取的 binlog,等于把复制链掐断。查了三条——没有 master.info、没有 relay-log、show slave status 是空的——确认是单机,才敢动。
然后停库。这里有个细节:直接 kill mysqld 不行,mysqld_safe 会把进程自动拉回来,你前脚删它后脚又起。得先把 mysqld_safe 也停掉,再确认进程真没了,才 rm mysql-bin.*。
删完重启,我自己发现不对:rm mysql-bin.* 把 index 文件也一起删了。那个 mysql-bin.index 记录着所有 binlog 的清单,是 MySQL 启动时要读的。当时心里一紧,怕它起不来。结果它自己重建了——起来后 ./mysql-bin.000001 已经就位,index 里也重新登记上了。有惊无险,但这一步不该靠运气,通配符该把 index 排除掉。
回头看,这件事留下的三个尾巴,我都在报告里写明了:binlog 是 rm 删的、不是 PURGE,日后加从库会缺一段历史日志;库里没有过期策略,它还会再涨;盘上还有 12G 多的旧备份可以接着清。第三条尤其要说——清 binlog 只是把水位压下去,治本得让它别再涨。
顺带一句,那 1.4G 的 err 文件,是 Windows 版 MySQL 留在中文机上的遗留,2026-09-25 之后就没人写了。清这种文件前我做了三个动作:lsof 确认没有进程占用、确认它不是当前在写的 error log、tail -n 500 先留个底再清空。大文件谁都会清,清了不出事才算数。
那台机器上的排查其实不止 binlog 这一层,挂载掉那篇里写过,磁盘满只是表症,底下还压着一条依赖链,一环带一环。工具能帮上忙的地方,是把「哪几个目录在涨」直接摆出来,省掉手动 du 那一遍;七亿批量远程管理工具说明书里这类只读排查的命令,我都按「每条看什么」标了。至于整库的容量规划,还是得人来定——工具只负责把数字给你,判断留在人这边。
评论